模型 · 深度词条
Embedding(向量嵌入)
把文字、图片或商品变成一串数字,让含义或用途相近的对象在向量空间里更靠近。
四层解释
通俗
把文字、图片或商品变成一串数字,让含义或用途相近的对象在向量空间里更靠近。
专业
Embedding 是学习得到的稠密向量表示,其几何关系编码与训练目标相关的相似性和结构。
机制
模型通过预测或对比学习调整向量,使相关样本距离更近、不相关样本更远;相似度可用点积或余弦计算。
工程
Embedding 的模型版本、维度、归一化方式和领域数据必须固定记录;更换模型后通常需要重新建索引并复测召回。
全链路位置
INPUT文本、图像或离散实体
→PROCESS编码器映射到连续向量空间
→OUTPUT可比较、检索或输入下游模型的向量
常见用途
- 语义搜索
- 推荐和聚类
- RAG 检索
专业边界
- 距离表示训练目标下的相似,不是客观真理
- 不同模型的向量通常不能直接混用
常见误解
- 向量保存了原文全部信息
- 维度越高检索一定越好
书架上的近邻
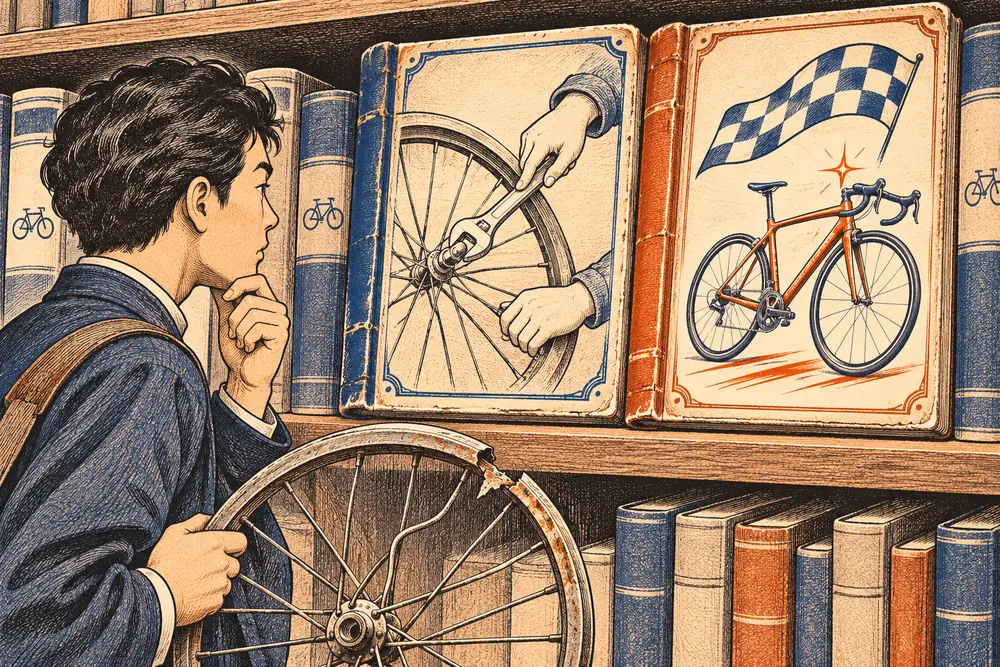
虚构示例
小林带着坏车轮去图书馆。管理员给了他相邻的两本书:一本教人调辐条,一本讲公路赛的历史。它们都和自行车很近,只有一本能告诉他扳手该往哪边转。
自拟教学说明
Embedding(嵌入)把输入转换成一组数,让系统能按某种相似度比较它们。“同一排书架”只是直觉:向量可以有很多维,相近也取决于模型、任务和度量。找到了近邻,不等于找到了能回答问题的证据。
从词向量到整段内容的表示
Word2Vec 是早期学习词向量的代表;今天用于检索的 Sentence Embedding 通常表示句子或段落。它们都用数值表示信息,但训练目标和适用对象不同,不能把某个词向量示例当作所有 Embedding 模型的工作细节。
相似度来自同一套表示空间
工程判断
语义检索通常用兼容的模型编码查询与文档,再比较向量。数值相近只表示该表示空间中的相似,不证明内容真实或可授权访问。更换模型后,本站建议重新建立或验证索引,并用中文、专有名词、否定句等实际样本检查召回。
Worked Example
查找退款规定
虚构教学示例,不对应真实业务数据或性能承诺。
- 分别编码
把用户的“钱什么时候退”和政策段落转为可比较的向量。
- 检索候选
找到语义相关的退款段落,但保留版本和用户权限过滤。
- 核对证据
检查退货和退款是否被混淆,再将有效段落交给生成环节。
Embedding 帮助找到相关内容,不能替代权限、时效和事实判断。
来源与核对记录
S1Machine Learning GlossaryGoogle for Developers · 官方技术文档 · 查阅 2026-10-24
↗S2Efficient Estimation of Word Representations in Vector SpaceMikolov et al. · 原始论文 · 查阅 2026-10-20
↗S3Semantic SearchSentence Transformers · 官方开源文档 · 查阅 2026-10-20
↗S4Search ConceptsWeaviate · 官方技术文档 · 查阅 2026-10-20
↗基础释义核对:2026-10-20。专题核对:2026-10-20。局部增补:2026-11-19。局部修订不代表旧正文全部复核,尚未完成外部专家审稿。