产品 · 深度词条
Evaluation Set(评测集)
一组能代表真实任务的输入、标准答案或评分规则,用来比较模型和发现回归。
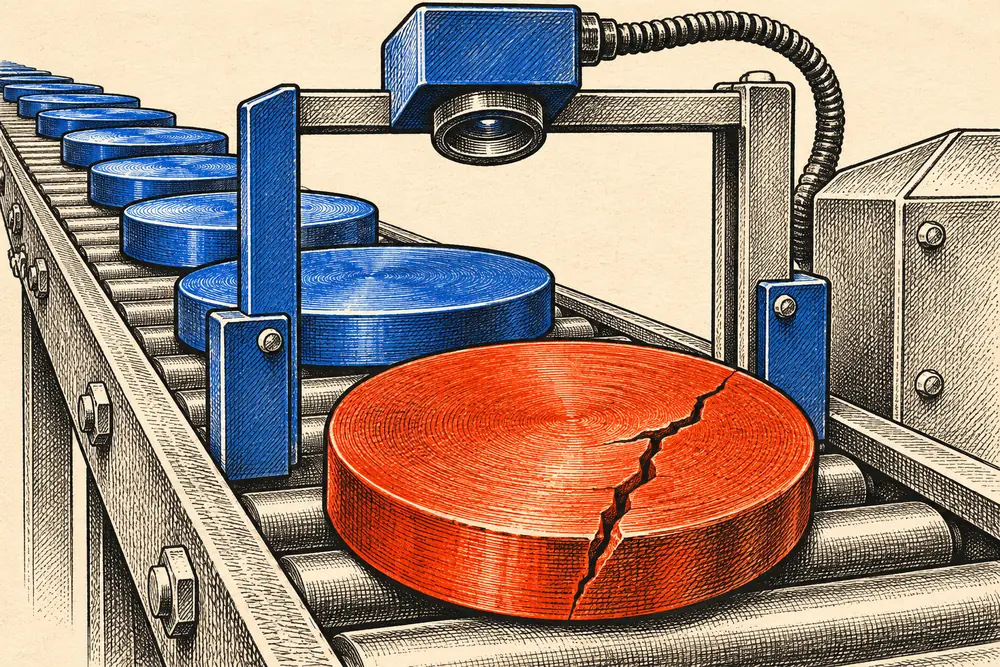
98% 准确率,也可以漏掉全部异常
- 1000 件 · 教学算例
- 980 件正常,20 件异常。假设系统把所有零件都判为正常。
- 准确率 98%
- 判对 980 件 ÷ 全部 1000 件。
- 异常召回率 0%
- 查出 0 件 ÷ 实际异常 20 件。要评估漏检,应看这个分母。
四层解释
通俗
一组能代表真实任务的输入、标准答案或评分规则,用来比较模型和发现回归。
专业
评测集是从目标任务分布抽样并经过版本管理的测试集合,可结合确定性评分、模型评分和人工评分衡量质量、风险、成本与延迟。
机制
先定义能力和失败分类,再收集正常、边界与对抗样本;固定运行配置,计算指标并保留失败案例供版本比较。
工程
训练数据、调参集和最终测试集必须隔离;评测应覆盖真实流量分布、高风险长尾和产品完整链路。
全链路位置
INPUT任务样本、参考答案与评分量表
→PROCESS固定条件运行并分类失败
→OUTPUT可比较指标、置信区间和案例记录
常见用途
- 模型选型
- Prompt 与 RAG 回归
- Agent 和安全测试
专业边界
- 任何评测只代表其样本与评分规则
- 公开榜单不能替代业务评测
常见误解
- 样本越多就一定越有代表性
- 一个总分足以解释所有质量
裁缝的三件试穿样衣
虚构示例
裁缝每改一次纸样,就让同三位熟客试穿。第三次,三个人都说合身。交货那天,一位肩宽相同、抬臂习惯不同的顾客却够不到高处的衣架。熟客帮他改好了样衣,却没替所有人试穿。
自拟教学说明
Evaluation Set(评测集)要覆盖产品真正面对的任务和差异。反复据以改系统的样例仍适合排错,却不再是独立的最终检验;留出没拿来调过的样例,才更容易看见此前漏掉的问题。
评测集为什么是产品资产
评测基础
评测集应从真实任务中抽样,包含标准输入、期望行为与评分方法。训练集、调参用验证集和最终测试集要分开,避免反复看答案造成数据泄漏。
指标设计
生成式系统不能只算单一准确率。至少按任务正确性、证据、有害输出、越权、延迟、成本和人工返工分层;高风险子群体与罕见失败需要单独看。
98% 准确率为什么仍可能毫无用处
指标定义
二分类中,TP 是正例判对,FP 是负例误报为正,FN 是正例漏检,TN 是负例判对。Accuracy = (TP + TN) / 总样本数;Precision = TP / (TP + FP);Recall = TP / (TP + FN)。这些指标要连同正类定义和判定阈值一起报告。
自拟算例
自拟例子:1000 条样本中只有 20 条正例。全部预测为负时,TN = 980、FN = 20、TP = FP = 0,Accuracy 为 98%,Recall 为 0%;Precision 的分母为 0,数学上未定义,软件约定的填充值不能当成测得的 100%。
自拟算例与评测方法
若另一系统得到 TP = 16、FP = 4、FN = 4、TN = 976,则 Accuracy 为 99.2%,Precision 与 Recall 均为 80%。选阈值时还要看误报和漏报的成本,不能只追一个更大的总分;样本量、切分方式与不确定性也要记录。
开放回答怎样判定是否有据
本站建议的评分方法
分类指标不能直接替代开放回答质量。自拟一份证据量表:资料明确支持该主张记‘支持’,资料与主张冲突记‘不支持’,资料未涉及或无法判定记‘资料不足’。逐条拆出可核验主张,保留所依据的原文和版本,不让一个正确引用替整段回答背书。
自拟示例
例如制度写‘报销上限 300 元’,回答‘上限 300 元’有据;回答‘上限 500 元’冲突;回答‘明年将提高到 500 元’若无新制度则资料不足。引用支持率只衡量与给定资料的一致性,不证明资料本身真实、最新或适用于该用户;还需单独检查任务正确性与资料质量。
从离线分数走到线上验证
运行方法
模型、Prompt、知识库或工具改动时跑同一批回归任务,再用小流量观察真实结果。公开榜单有助了解趋势,但可能受数据污染、题目老化和测量方式影响。
来源与核对记录
S1Evaluation Best PracticesOpenAI · 官方技术文档 · 查阅 2026-09-07
↗S2NIST AI Risk Management Framework 1.0NIST · 标准与框架 · 查阅 2026-09-07
↗S3Building Effective AgentsAnthropic · 官方工程文章 · 查阅 2026-09-07
↗S4Machine Learning GlossaryGoogle for Developers · 官方技术文档 · 查阅 2026-10-24
↗S5NIST AI RMF PlaybookNIST · 官方治理框架 · 查阅 2026-10-03
↗S6AI Index 2026: Technical PerformanceStanford HAI · 研究报告 · 查阅 2026-10-03
↗S7Classification: Accuracy, recall, precision, and related metricsGoogle · 官方课程 · 查阅 2026-10-24
↗S8NeurIPS Paper Checklist GuidelinesNeurIPS · 官方研究规范 · 查阅 2026-10-24
↗基础释义核对:2026-09-07。专题核对:2026-10-03。局部增补:2026-11-19。局部修订不代表旧正文全部复核,尚未完成外部专家审稿。