Chapter 04
AI 产品工程
把模型接入需求、权限、检索、工具、校验、监控和持续评测的生产链路。
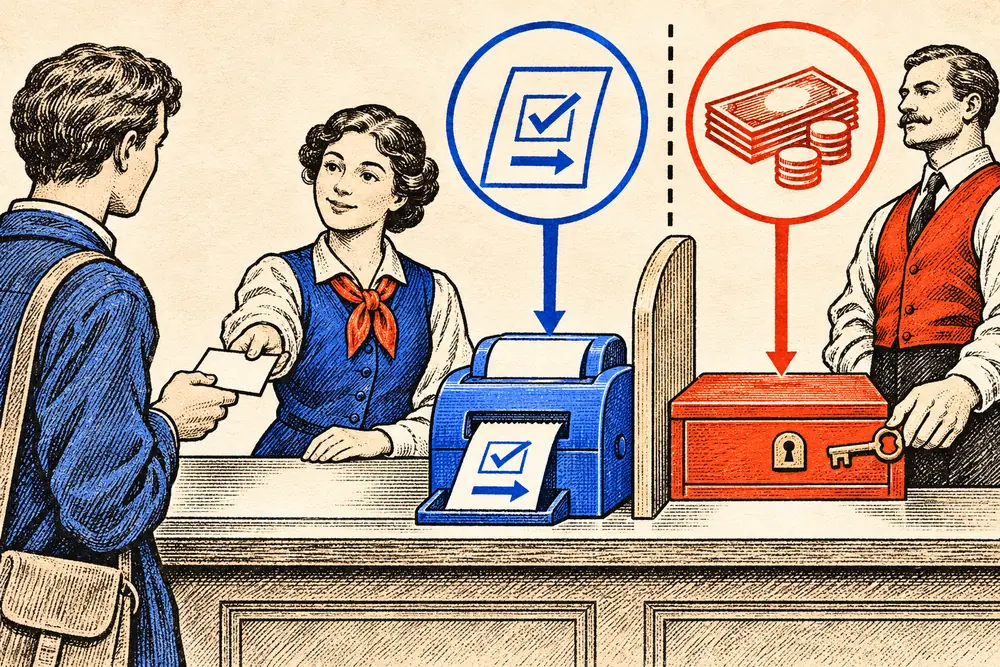
模型建议退款,谁能打开钱箱?
- 界面与模型
- 界面接收诉求;模型结合已获准读取的订单资料,提出退款建议。
- 权限与工具
- 应用核验身份、金额和审批条件。只有通过校验,支付工具才执行退款。建议不是授权。
本章核心判断
Demo 只需展示一次成功,产品必须为失败、成本、权限和恢复负责。
客服说改好了,快递为什么还去了旧址?
虚构示例
顾客要求改收件地址。助手回复“改好了”,仓库却照旧发货。店长一查:助手读懂了新地址,但包裹已出库,订单系统拒绝修改。第二版把成功提示放到回执之后;同样的请求,这次顾客看到的是“未改成,包裹已出库”。
自拟教学说明
语言模型可以识别意图、整理参数,却不能靠一句回复改变订单。产品需要区分请求、执行和结果;收到确认才报成功,收到拒绝就讲明原因,没收到回执则保留“结果待确认”。
先找到可测量的任务,而不是先接模型
产品方法
把业务问题写成‘谁在什么条件下,读哪些数据,交付什么结果,错误由谁承担’。再记录没有 AI 时的耗时、准确率和成本。若目标模糊,模型演示即使流畅也无法判断是否创造价值。
风险边界
优先选择高频、可验证、错误可恢复的任务,例如有制度依据的客服草稿;对不可逆交易、医疗结论或人事决定保留明确的人工决策与申诉路径。‘人审’必须说明审批者看什么证据、能否拒绝和怎样回滚。
把应用拆成可负责的系统边界
工程结构
典型链路包含身份认证、输入校验、知识检索、上下文构造、模型调用、工具执行、输出校验与日志。Prompt 是其中一层;它不能代替数据库权限、业务校验或系统审计。
安全机制
工具应由应用暴露最小权限的 Schema,服务端验证参数与操作者身份。模型提出‘查询订单’只能算请求,不能凭文字越过订单归属检查;外部文档中的指令应当作数据处理。
建立失败分类、评测集和发布门槛
评测方法
评测集要覆盖正常任务、无答案、旧资料、矛盾来源、权限边界和恶意输入。分别看完成率、有据性、引用准确率、拒答质量、延迟和每完成任务成本,并保存样本与评分规则。
工程判断
每次改模型、Prompt、检索或工具后都跑同一批回归样本,同时审查新失败。不要只用单次满意度或通用榜单判断上线;不同业务的可接受错误率和人工成本不同。
上线后的监控、成本和恢复
运营方法
生产监控应把失败按模型、检索、工具、权限与界面分组,并记录输入版本、知识库版本和模型版本。敏感内容应遵守数据保留与最小化规则,日志能追责但不应成为新的泄露源。
工程判断
为超时、服务降级、错误工具调用和模型版本变更准备可测试的回退路径。预算应按‘成功完成一项任务’计算,包含重试、人工复核和事故处置,而不只看每百万 Token 价格。
2026-10-20 增补:模型升级也是一次产品发布
时效事实
模型别名可能被供应商映射到新版本。DeepSeek 的公开文档给出了旧别名继续接受、后端模型却已替换的例子。因此,“代码没有改”不能作为不做回归的理由。
工程判断
本站建议保存当前基线,使用相同输入和评分规则比较候选版本,分别记录任务成功率、错误类型、延迟与成本。先小范围验证,再决定放量;不能只看几次令人满意的回答。结构化输出检查接口是否可解析,Trace 帮助定位过程,两者都不能代替任务质量评测。
Worked Example
企业知识助手的最小发布门槛
以下为虚构教学示例,不代表真实公司的运行指标。
- 任务
仅回答员工当前有权限查看的制度条款,并附原文和生效日期。
- 评测
准备正常、过期、冲突、无权限与无答案五组题,分别记录错误类型。
- 权限
检索前过滤部门与角色;工具请求由服务端二次鉴权。
- 发布
设定错误升级与人工复核路径,先灰度再扩大使用范围。
产品质量来自完整工作流,不来自一段更长的 Prompt。