Chapter 01
AI 历史脉络
从符号主义、连接主义和统计学习三条思想主线理解 AI 的兴起、寒冬与复兴。
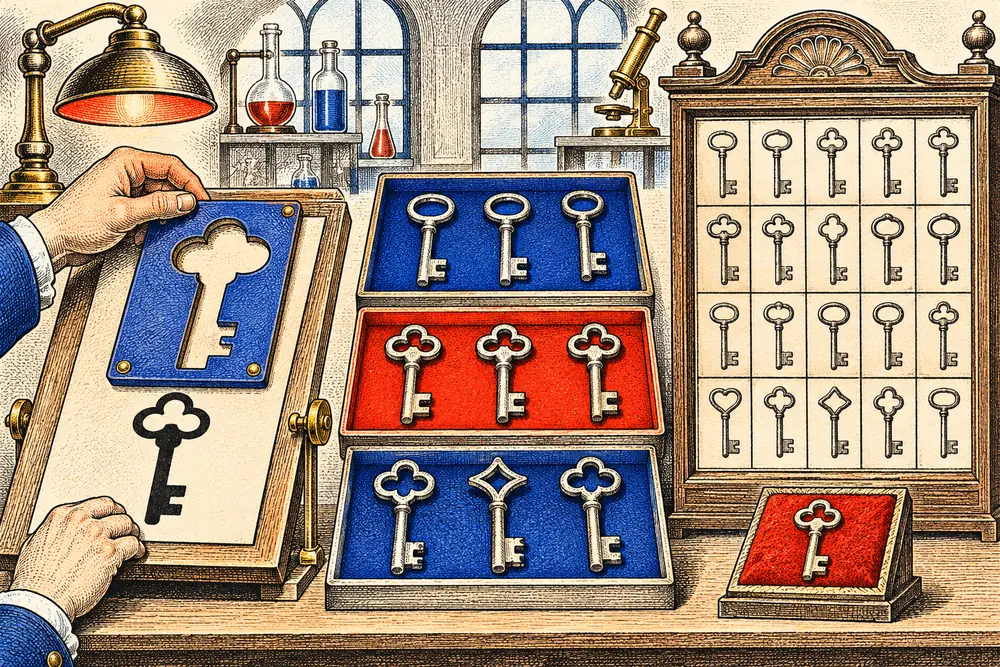
认出一把钥匙,有三条路线
- 规则
- 由人规定要检查哪些轮廓。换个角度,旧规则可能失效。
- 从样本学习
- 提供带标签的样本,让模型从差异中学习分类。
- 预训练再适配
- 先从广泛数据学习表示,再用于钥匙识别。三种路线今天仍可并用。
本章核心判断
AI 的进步从来不只由算法推动,而是思想、数据、算力、评测和商业需求共同越过临界点。
两把黑伞,哪把是我的?
虚构示例
失物招领处原先按颜色和伞柄形状找伞。直到下雨那天,柜台收来了十几把黑色直柄伞。小周拿出旧照片,电脑把有相似划痕的两把排在最前。管理员却没马上交伞,而是请他描述伞带内侧的记号。
自拟教学说明
柜台用了两种不同的办法:按条件筛选,条件由人写;从照片里找相似的划痕,哪些特征有用可以从样本中学。后者缩小了范围,却没有回答谁有权领走伞。理解 AI 历史,不必把规则和学习想成前后两代只能留一个。
在 AI 得名之前,问题已经形成
历史事实
1943 年的人工神经元模型、1950 年图灵对机器智能的讨论,并不是今天大模型的直接产品蓝图,却提出了两个长期问题:能否用计算表示智能行为,以及怎样观察机器的能力。图灵的模仿游戏讨论的是可观察行为,不是意识的证明。
历史事实
1955 年达特茅斯研究提案已经使用 Artificial Intelligence 一词,并计划于 1956 年举行暑期研究。提案同时讨论语言、神经网络、抽象和自我改进,说明 AI 从一开始就不是单一算法路线。
符号规则为什么兴起,又为什么遇到边界
历史解释
早期符号主义把知识写成逻辑、搜索和规则,专家系统在边界清楚的诊断与配置任务中有价值。但开放世界的常识、歧义与例外太多,知识获取、维护和计算成本难以跟上承诺。两次所谓 AI 寒冬不是研究完全停止,而是预期、资金和可交付能力失衡。
方法判断
不能把历史写成‘规则失败,神经网络胜利’。今天企业 AI 仍需要业务规则、数据库、检索和审批;神经网络负责学习复杂模式,显式规则负责确定性约束。两条路线在产品系统中共存。
统计学习与深度学习改变了问题的表达方式
历史事实
互联网数据、GPU 和可比较的任务评测推动机器学习从手写规则转向从样本估计模式。AlexNet 的 2012 年 ImageNet 工作是深度视觉的重要转折;AlphaGo 公开论文展示了深度网络与树搜索结合,而不是仅靠单一模型‘理解’围棋。
分析框架
这阶段的因果链是任务可测量、数据可获得、训练可计算、结果可复现。没有合适的评测和部署场景,论文突破不会自动变成可靠产品。
Transformer、基础模型和大众产品
历史事实与边界
2017 年 Transformer 提供了以 Attention 为核心的序列架构;随后大规模预训练与后训练让同一底座适配更多任务。2022 年 ChatGPT 把对话式交互推向大众,但‘研究方法公开’不等于现役模型的数据、参数和服务架构全部公开。
当前观察
到 2026 年,比较 AI 发展应同时看能力、评测有效性、成本、分发和治理。Stanford AI Index 指出前沿能力持续提高,也指出评测饱和和应用可靠性仍是问题;因此时间线是理解变化的入口,不是技术胜负表。